Estudo da Nature Mostra Domínio do Gemini 3.1 Pro e LLMs Gerais na Medicina
Estudo da Nature Medicine revela que modelos de linguagem generalistas, liderados pelo Gemini 3.1 Pro, superaram IAs médicas especializadas (como OpenEvidence e UpToDate) em resolução de casos reais e benchmarks clínicos.
Introdução
O uso da Inteligência Artificial (IA) na medicina deixou de ser algo impossível para se tornar realidade. Até recentemente, a crença predominante era de que modelos especializados — treinados exclusivamente com prontuários, artigos médicos e diretrizes clínicas — seriam muito superiores aos modelos de propósito geral (como o ChatGPT ou o Claude), que aprendem com a internet inteira.
Porém, um estudo recém-publicado na prestigiosa revista Nature virou essa premissa de cabeça para baixo.
Resumidamente: Os Large Language Models (LLMs) de propósito geral não apenas competiram de igual para igual, como superaram ferramentas de IA clínica especializadas em vários testes e benchmarks médicos.
O que o estudo da Nature avaliou?
Neste estudo (General-purpose large language models outperform specialized clinical AI tools on medical benchmarks), os pesquisadores realizaram um “teste de estresse” em 3 etapas para comparar grandes LLMs (GPT-5.2, Gemini 3.1 Pro e Claude Opus 4.6) contra ferramentas clínicas pagas ou de acesso restrito a médicos e estudantes (OpenEvidence e UpToDate Expert AI) e o próprio Google AI Overview (a IA da busca web do Google).
A avaliação foi dividida em:
- MedQA (500 questões): Questões de provas de residência médica, no estilo do USMLE, a maior prova médica dos EUA, para testar o conhecimento técnico.
- HealthBench (500 itens): Avaliação de alinhamento com protocolos médicos.
- Real Clinical Queries - RCQ (100 consultas reais): Perguntas reais feitas por médicos durante o trabalho clínico no hospital NYU Langone, que depois foram avaliadas às cegas por 12 médicos especialistas (1.800 avaliações no total).
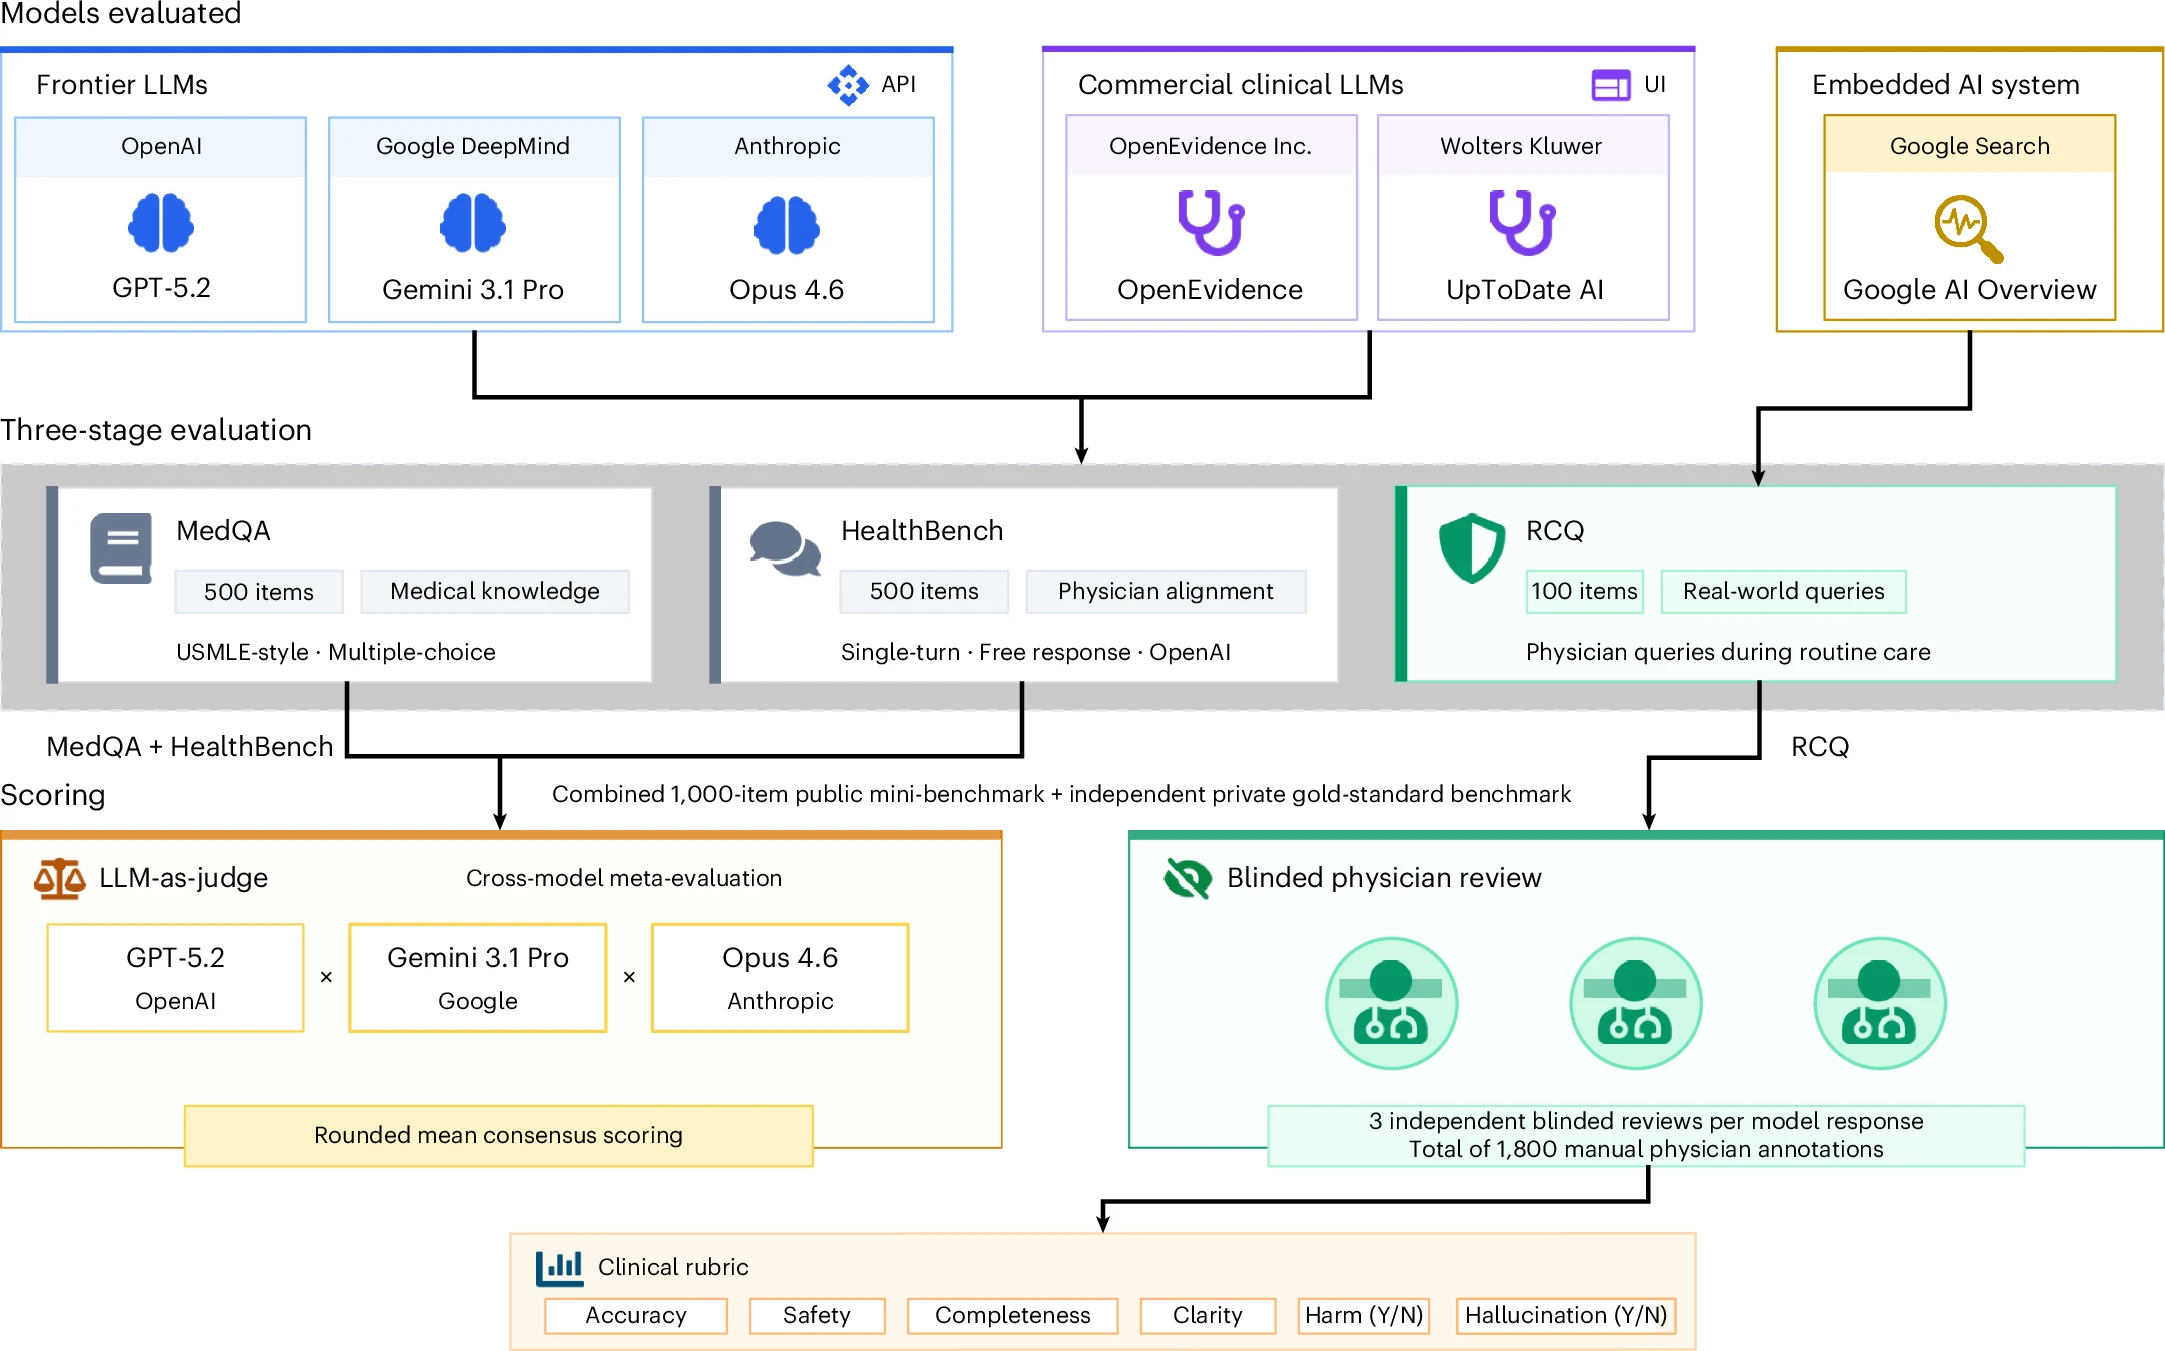 Visão geral esquemática da análise comparativa entre modelos de IA de fronteira, específicos clínicos e integrados em pesquisa. O modelo integra pontuação automatizada (MedQA e HealthBench) com avaliações clínicas cegas e randomizadas de alta fidelidade (RCQ) para avaliar o desempenho do modelo através de métricas de precisão, segurança e confiabilidade.
Principais Descobertas
O resultado surpreendeu muita gente, pois os modelos gerais superaram os modelos médicos dedicados em absolutamente TODAS as etapas:
- Conhecimento Médico (MedQA): O Gemini 3.1 Pro liderou de forma isolada com 97.4% de acurácia. A liderança do modelo do Google foi estatisticamente significativa, superando todos os outros modelos (McNemar P < 1x10^-4 contra OpenEvidence, UpToDate e Claude; P = 0.02 contra o GPT). O GPT (94.2%) também superou o OpenEvidence (P = 0.008), UpToDate (P = 0.0004) e Claude (90.2%; P = 0.04). As ferramentas clínicas ficaram para trás (OpenEvidence com 89.6% e UpToDate Expert AI com 88.4%).
- Desempenho no Mundo Real (RCQ): Na avaliação cega feita por médicos sobre casos reais, os LLMs generalistas lideraram na elite. O OpenEvidence pecou na clareza (respostas desorganizadas e incompletas), enquanto a IA do UpToDate se recusou a responder 19% das perguntas com medo de errar (taxa de recusa infinitamente maior que os modelos gerais). Curiosamente, o desempenho clínico dessas ferramentas pagas foi estatisticamente igual ao de uma simples pesquisa no Google AI Overview.
- Segurança e Alucinação: O grande medo de usar ChatGPT na medicina é ele “inventar” coisas (alucinar) e causar danos. O estudo provou que não houve diferença estatística na taxa de alucinação ou de conteúdo prejudicial entre os modelos genéricos e os clínicos. A IA geral é tão segura quanto a IA médica, mas muito mais competente em se comunicar.
Aprofundando nos Dados do Estudo
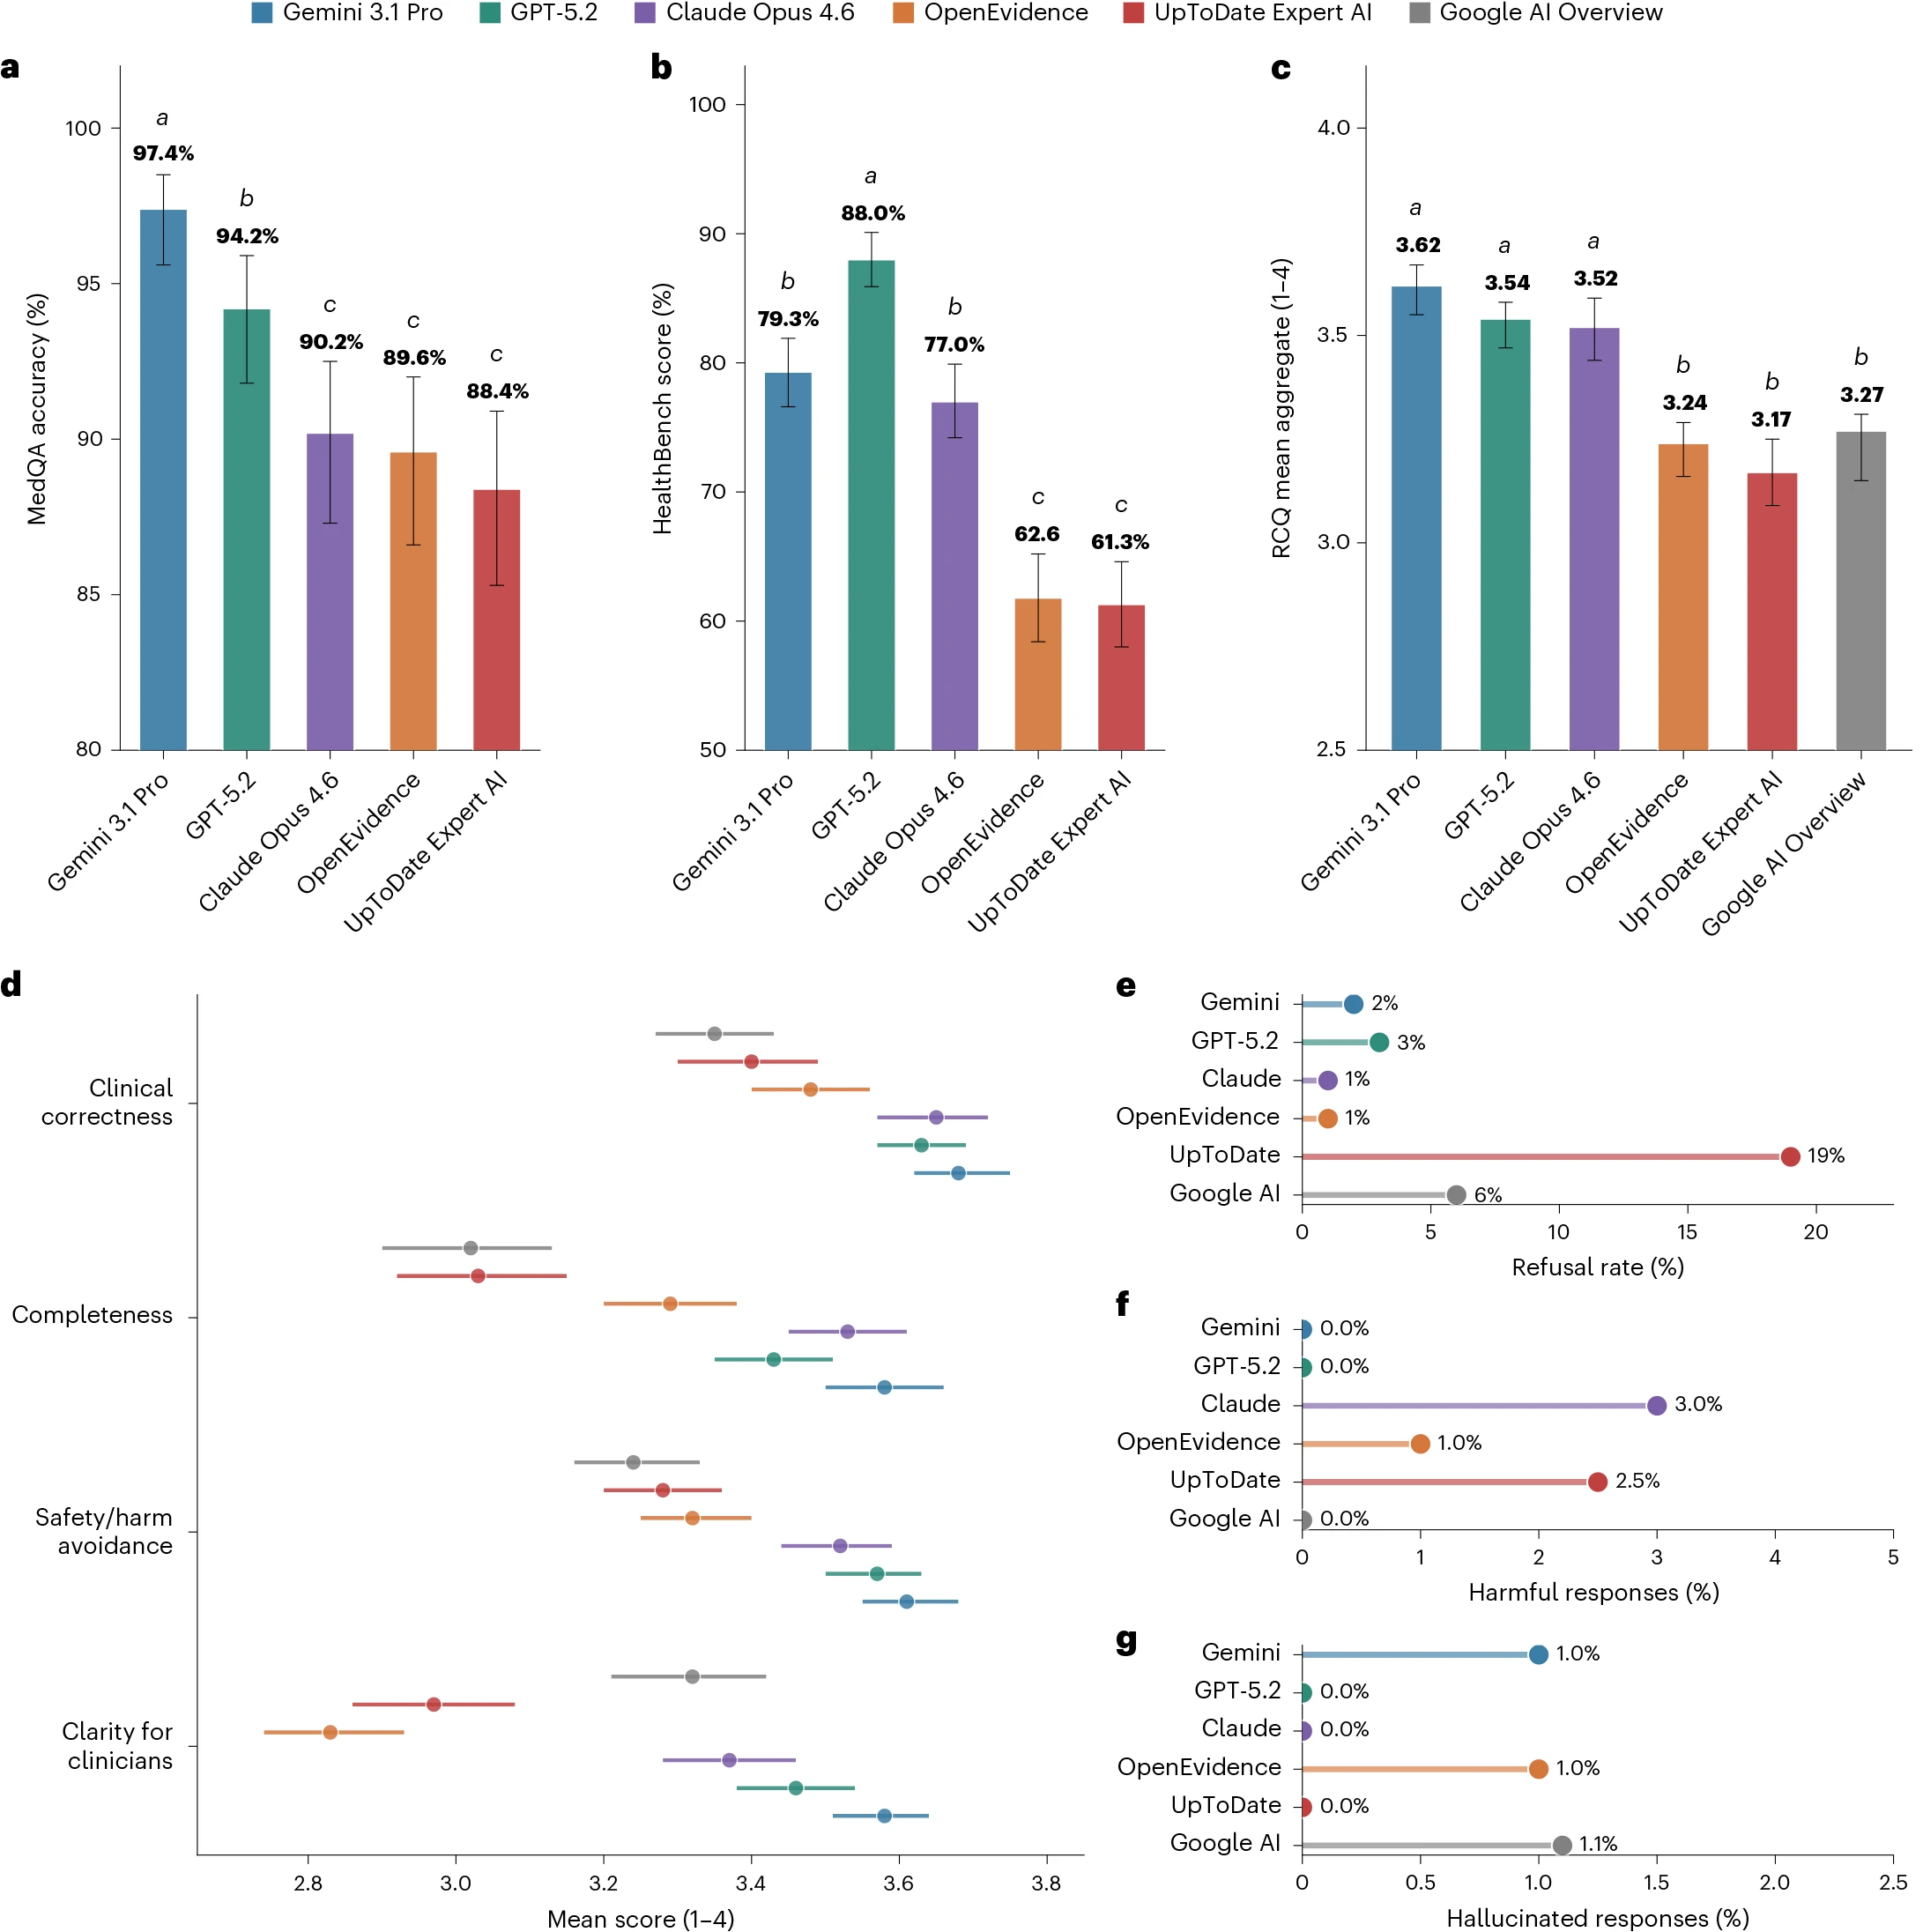 Para entender os gráficos acima: Refusal rate refere-se à taxa de recusa em responder a pergunta. Harmful responses indica a proporção de respostas prejudiciais ou perigosas geradas. Hallucinated responses aponta para a invenção de fatos (alucinações).
A análise detalhada mostra dados muito interessantes:
- Acurácia (MedQA) e Alinhamento (HealthBench): Nos gráficos (a) e (b), fica nítido como os modelos de fronteira (Gemini, GPT e Claude) alcançam um patamar superior de acertos.
- Avaliação Humana (RCQ): No gráfico (c), onde médicos deram notas de 1 a 4 para respostas de casos reais, a “elite” generalista pontuou entre 3.52 e 3.62, enquanto as IAs médicas e o Google AI Overview ficaram todos empatados na faixa de 3.17 a 3.27.
- Segurança não é desculpa: Os gráficos (f) e (g) destroem o mito de que IAs médicas são “mais seguras”. As proporções de respostas com conteúdo perigoso (Harmful) ou dados inventados (Hallucinated) foram estatisticamente iguais entre todos os sistemas analisados.
Para comprovar ainda mais essa disparidade, os pesquisadores analisaram as taxas de vitória em confrontos diretos (Head-to-Head Win Rates):
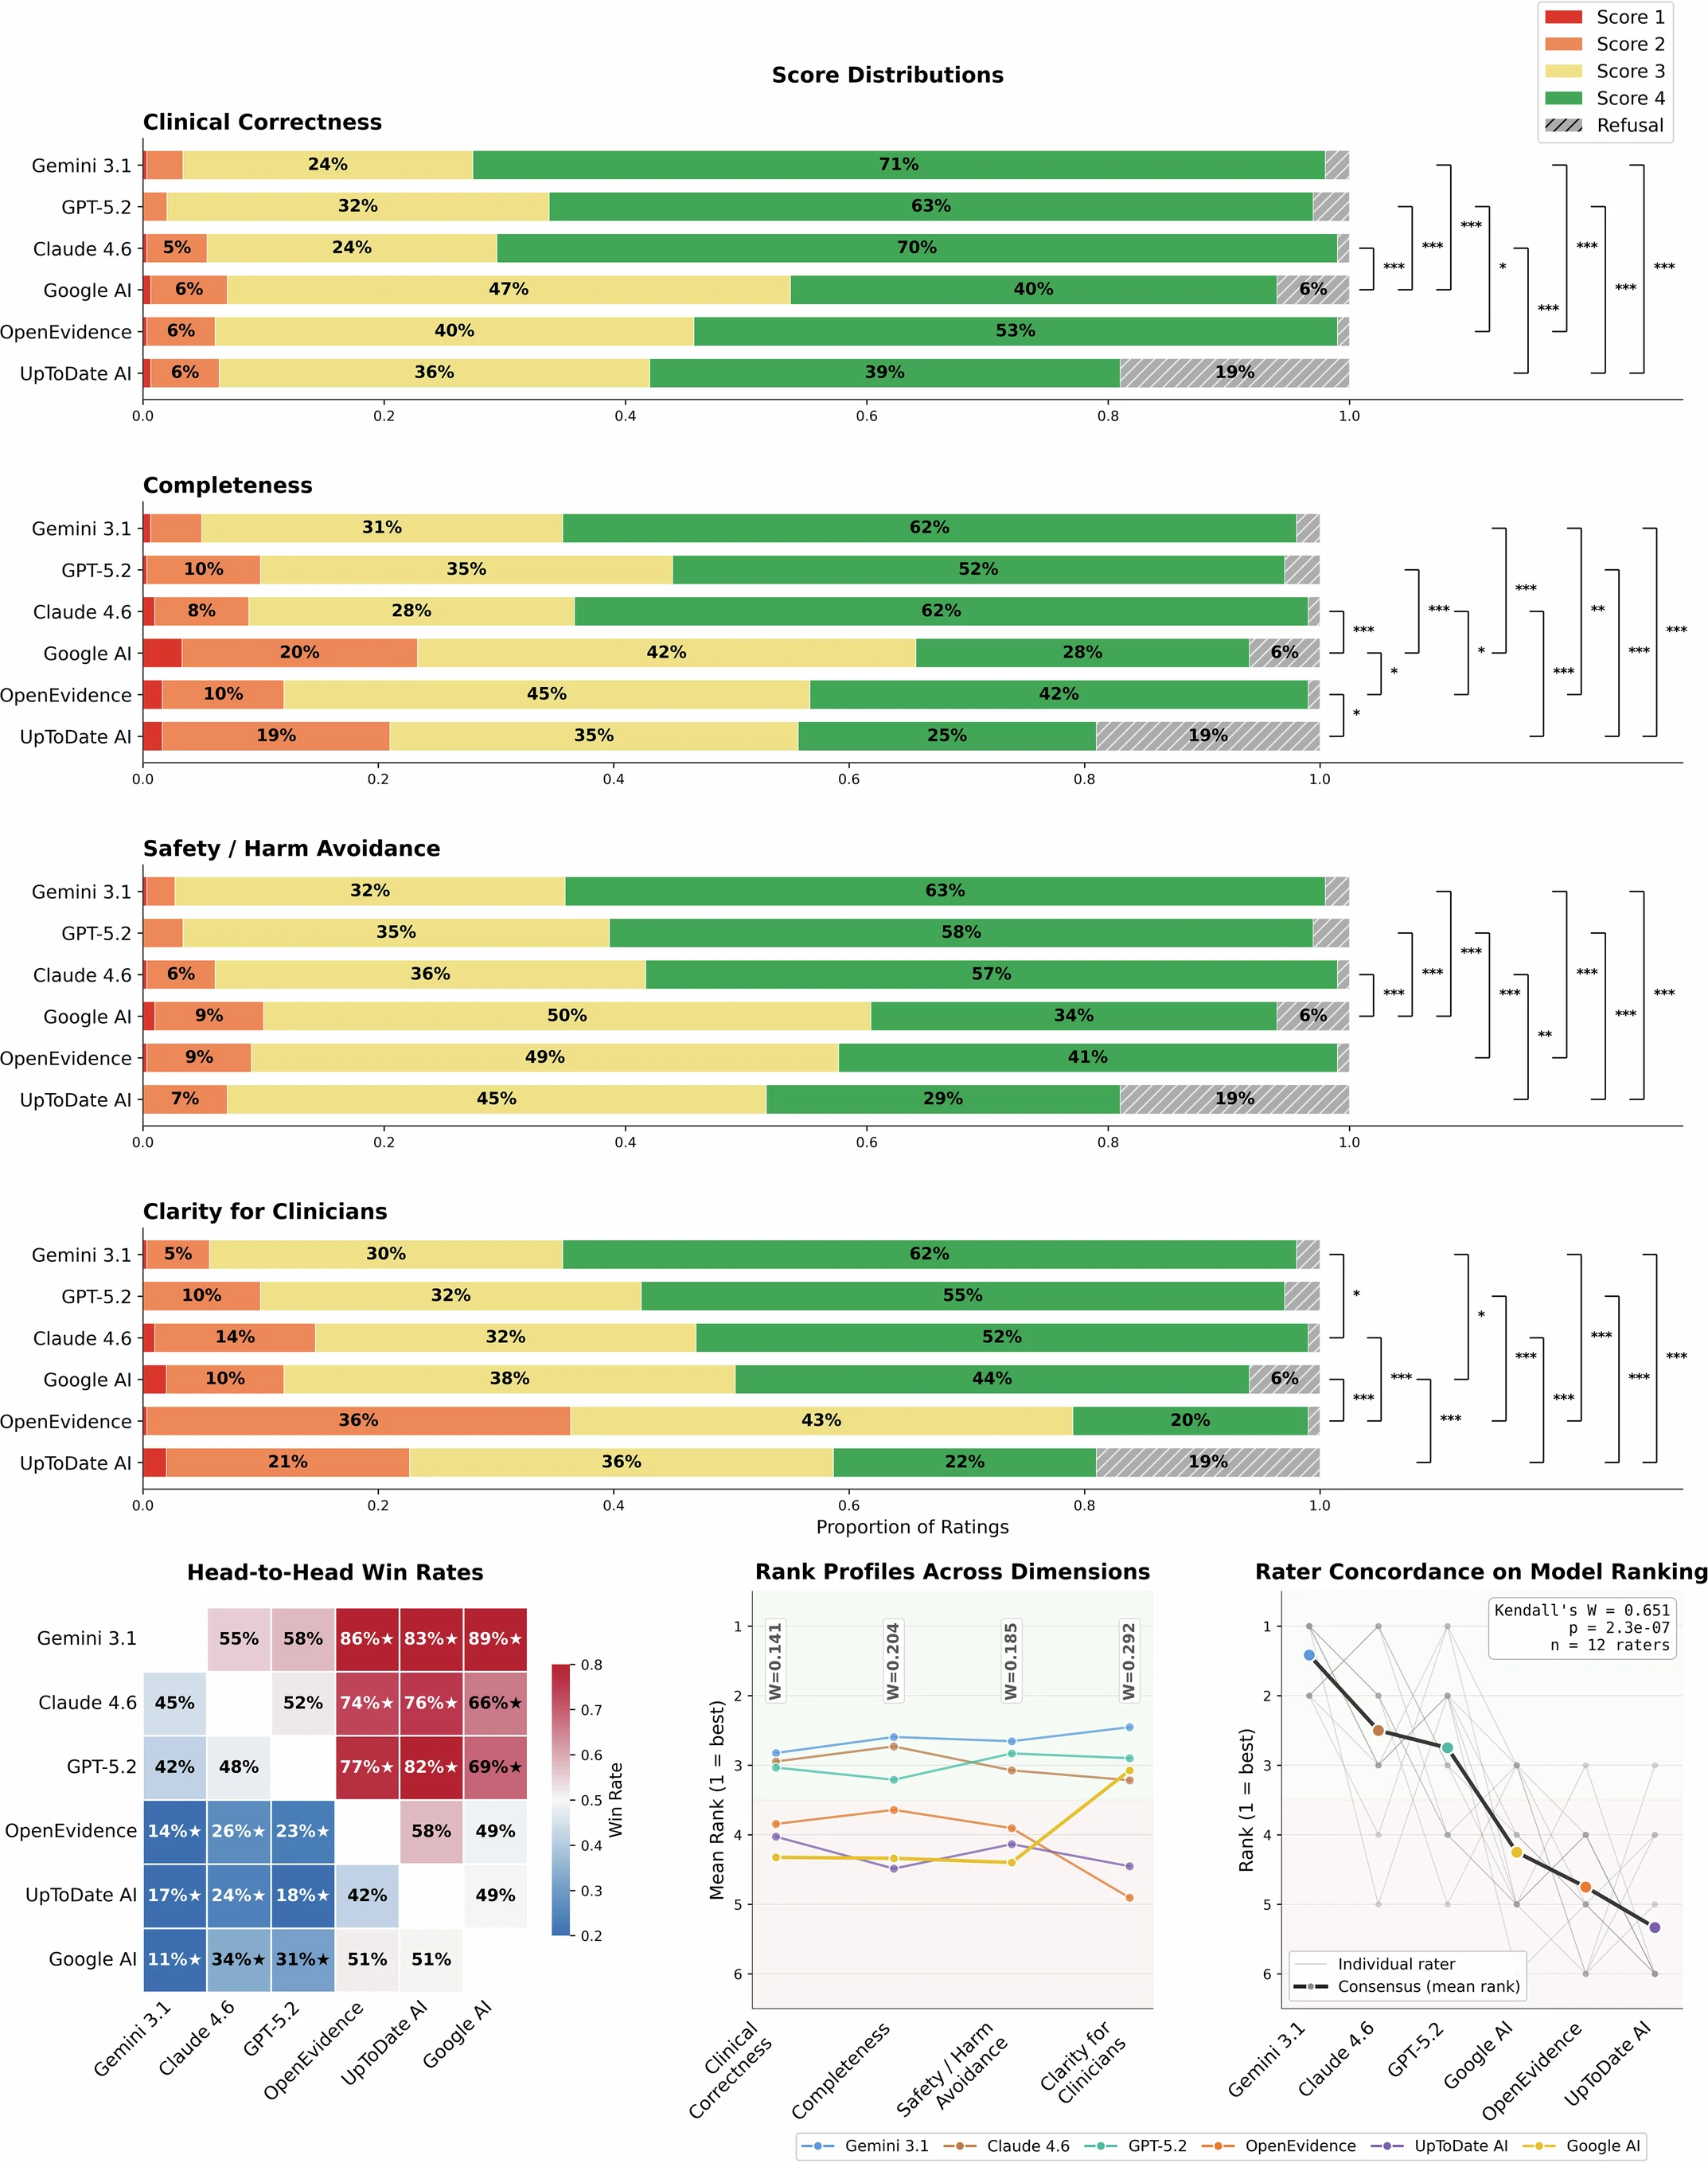
Ao colocar cada modelo frente a frente para as mesmas 74 questões clínicas reais e completas:
- O Gemini 3.1 Pro venceu o OpenEvidence em 86% das vezes e o UpToDate Expert AI em 89% das avaliações.
- O GPT-5.2 também atropelou os sistemas médicos, vencendo 77% das vezes o OpenEvidence e 82% das vezes o UpToDate.
- A matriz mostra que os sistemas generalistas, de forma praticamente unânime entre os 12 médicos avaliadores, entregam respostas clinicamente superiores, mais claras e completas do que as ferramentas dedicadas exclusivamente à área da saúde.
O Que Isso Muda na Prática Clínica?
Nota para o autor (Diego): Aqui você pode adicionar a sua opinião pessoal como médico e dev do MedCalcApp. Fale sobre como você tem visto isso na prática e nos seus próprios testes.
Para nós, estudantes e profissionais da saúde, isso significa que as ferramentas que já estão no nosso bolso (ou no navegador) podem ser tão ou mais poderosas do que softwares hospitalares caros e exclusivos. Contudo, é fundamental não perder de vista que a IA não substitui o julgamento clínico. Ela é um excelente copiloto, sugerindo a rota, mas o médico ainda é quem deve estar com a mão no volante.
Conclusão
A publicação na Nature marca um ponto de inflexão na evolução das tecnologias de saúde. Talvez o futuro não seja gastar bilhões criando IAs isoladas para a medicina (sim, modelos de IA custam na casa de bilhões de doláres), mas sim pegar os “gigantes” da IA generalista e ensiná-los a se comportarem com a segurança, a precisão e a ética que a prática médica exige.
Referência Oficial: